Podczas regularnej kontroli reklamacji zamkniętych przez AI pracownik wraca do oryginalnych wiadomości klientów. W kilku sprawach odkrywa, że system rozpoznał opóźnienie dostawy, ale pominął zgłoszone jednocześnie uszkodzenie produktu. Przyznał rekompensatę i oznaczył reklamację jako zakończoną, choć nie rozpatrzył wszystkich żądań. To ten sam przypadek, na którym poprzednia część pokazywała, jak ustalać granice automatyzacji.
Monitoring techniczny nie sygnalizował problemu. Aplikacja działała, integracje odpowiadały, a wszystkie te zgłoszenia miały status „zakończone”. Gdyby nikt nie sprawdził źródłowych wiadomości, firma mogłaby przez długi czas nie wiedzieć, że automatyzacja podejmuje błędne decyzje.
To jedno z najważniejszych wyzwań utrzymania systemów opartych na AI. Nie wystarczy kontrolować dostępności aplikacji i błędów integracji. Trzeba obserwować sposób podejmowania decyzji, regularnie weryfikować ich poprawność i reagować, zanim podobne pomyłki dotkną kolejnych klientów.
W AI poprawność trzeba sprawdzać także po uruchomieniu
Klasyczne oprogramowanie również wymaga monitoringu, testów i utrzymania. W systemach opartych na AI dochodzi jednak szczególna trudność: aplikacja może wykonać wszystkie kroki technicznie poprawnie, mimo że model źle zinterpretował treść albo podjął niewłaściwą decyzję.
Testy przedwdrożeniowe pozwalają ocenić rozwiązanie na przygotowanych przypadkach. Po uruchomieniu pojawiają się jednak nowe sformułowania klientów, nietypowe kombinacje żądań i sytuacje, których wcześniejsze próby nie obejmowały. Wynik może też zmienić się po aktualizacji modelu, instrukcji, bazy wiedzy lub reguł biznesowych. Nawet bez takiej aktualizacji odpowiedzi modelu nie zawsze są identyczne dla podobnych danych.
Zaliczenie testów odbiorowych nie daje więc trwałego potwierdzenia jakości. W działającym systemie potrzebna jest regularna ocena rzeczywistych spraw. Nie oznacza to ręcznego sprawdzania każdej wiadomości ani nieustannego uruchamiania całego zestawu testów. Chodzi o zaplanowany nadzór odpowiedni do liczby spraw, rodzaju decyzji i skutków pomyłek.
Co można obserwować w samej aplikacji?
Żeby kontrolować sposób działania AI, trzeba zaprojektować odpowiednie zdarzenia i zapisy już na poziomie aplikacji. Nie wystarczy zachować informację, że wywołanie modelu zakończyło się sukcesem.
Dla każdej obsługiwanej sprawy system może odnotować, jaki rodzaj zgłoszenia rozpoznała AI, jakie działanie zaproponowała, czy przekazała sprawę człowiekowi, co rzeczywiście zostało wykonane i jaki status otrzymała reklamacja. Warto powiązać te informacje z wersją modelu, instrukcji i istotnych reguł, żeby później móc odróżnić zachowanie różnych konfiguracji. Oryginalne zgłoszenie i dane źródłowe muszą pozostać dostępne do uprawnionej weryfikacji, ale nie oznacza to konieczności kopiowania wszystkich danych osobowych do każdego logu.
Z takich zdarzeń można budować raporty i pulpity pokazujące na przykład udział spraw zamykanych automatycznie, częstość przekazywania ich pracownikom, rodzaje rozstrzygnięć, decyzje zmienione przez konsultantów i zgłoszenia ponownie otwarte przez klientów. Wskaźniki warto rozbijać na porównywalne kategorie spraw i wersje systemu. Sama średnia dla wszystkich reklamacji może ukryć pogorszenie w jednej, rzadszej kategorii.
Obserwować można również odpowiedzi i decyzje AI, nie tylko statusy serwerów. Część kontroli działa automatycznie: aplikacja porównuje komunikat o wykonanej operacji z jej stanem w systemie źródłowym, wykrywa brak wymaganych informacji lub kieruje do dodatkowej oceny nietypową decyzję. Można także użyć osobnego mechanizmu oceniającego treść, w tym innego modelu AI, żeby wskazywał odpowiedzi potencjalnie sprzeczne z wiadomością klienta albo z zasadami procesu.
Taki automatyczny oceniający może pomóc wybrać sprawy do sprawdzenia. Nie powinien jednak być jedynym dowodem poprawności. Drugi model również może przeoczyć ten sam problem albo błędnie zakwestionować prawidłowe rozstrzygnięcie. Ostateczne potwierdzenie niektórych błędów wymaga niezależnych danych lub oceny osoby znającej proces.
Nie zawsze potrzeba do tego specjalnej platformy AI. W zależności od skali mogą wystarczyć odpowiednio zaprojektowane zdarzenia w aplikacji, raport nad bazą danych, kolejka do kontroli jakości i powiadomienia. Ważniejszy od nazwy narzędzia jest zakres informacji, które rzeczywiście pozwala ono sprawdzić.
Jak mierzyć jakość, której nie widać w logach?
Wróćmy do pominiętego żądania klienta. Jeśli AI nie rozpoznała informacji o uszkodzonym produkcie, w systemie może w ogóle nie powstać zapis takiego roszczenia. Porównywanie statusów z zapisanymi przez nią kategoriami niczego wtedy nie wykryje.
Potrzebna jest regularna kontrola próbki prawdziwych spraw na podstawie materiału źródłowego. Pracownik znający zasady obsługi czyta oryginalne zgłoszenie, sprawdza istotne dane i porównuje je z decyzją oraz wiadomością wysłaną klientowi. Ocenia, czy rozpoznano wszystkie żądania, czy istniały podstawy do rozstrzygnięcia i czy sprawy nie zamknięto przedwcześnie. Jeśli zaczyna od samego podsumowania stworzonego przez AI, może nie zauważyć dokładnie tego, co model pominął.
Próbka powinna obejmować losowo dobrane automatycznie zakończone sprawy. Przy odpowiednim doborze i liczebności pozwala to szacować częstość błędów w tej grupie, choć wynik zawsze ma pewną niepewność. Osobno warto sprawdzać przypadki podwyższonego ryzyka: wielowątkowe wiadomości, nietypowe rozstrzygnięcia, skargi lub sprawy wytypowane przez automatyczny mechanizm oceny. Wyników takiej celowej kontroli nie należy łączyć z próbą losową w jeden „odsetek błędów systemu”, bo sprawy nie zostały wybrane w ten sam sposób.
Warto także kontrolować część zgłoszeń przekazanych człowiekowi. AI może poprawnie rozstrzygać sprawy, które sobie pozostawia, ale coraz częściej oddawać konsultantom proste przypadki, które wcześniej obsługiwała samodzielnie. Jakość automatycznych rozstrzygnięć będzie wtedy wyglądać dobrze, a korzyści z wdrożenia zaczną maleć. Dlatego osobno oceniamy trafność rozstrzygnięć i zasadność eskalacji, według ustalonych reguł procesu. Nie chodzi o ograniczanie liczby przekazań za wszelką cenę.
Wyniki należy zapisywać według rodzaju pomyłki, a nie wyłącznie jako jeden procent: pominięte żądanie, nieuzasadnione rozstrzygnięcie, błędny komunikat czy przedwczesne zamknięcie sprawy. To pozwala zdecydować, którą część automatyzacji trzeba poprawić lub ograniczyć. Odsetek ponownych zgłoszeń i liczba skarg są dodatkowymi sygnałami, ale nie mierzą wszystkich błędów, bo część klientów nigdy nie wraca z reklamacją.
Taką kontrolę trzeba wykonywać cyklicznie, a po istotnych zmianach modelu, instrukcji, danych lub zasad procesu zwiększać jej zakres albo częstotliwość. Testy regresji przed wprowadzeniem zmiany pozostają potrzebne. Przegląd produkcji odpowiada jednak na inne pytanie: jak system radzi sobie z rzeczywistymi sprawami, które napływają teraz?
Kiedy wynik monitoringu wymaga działania?
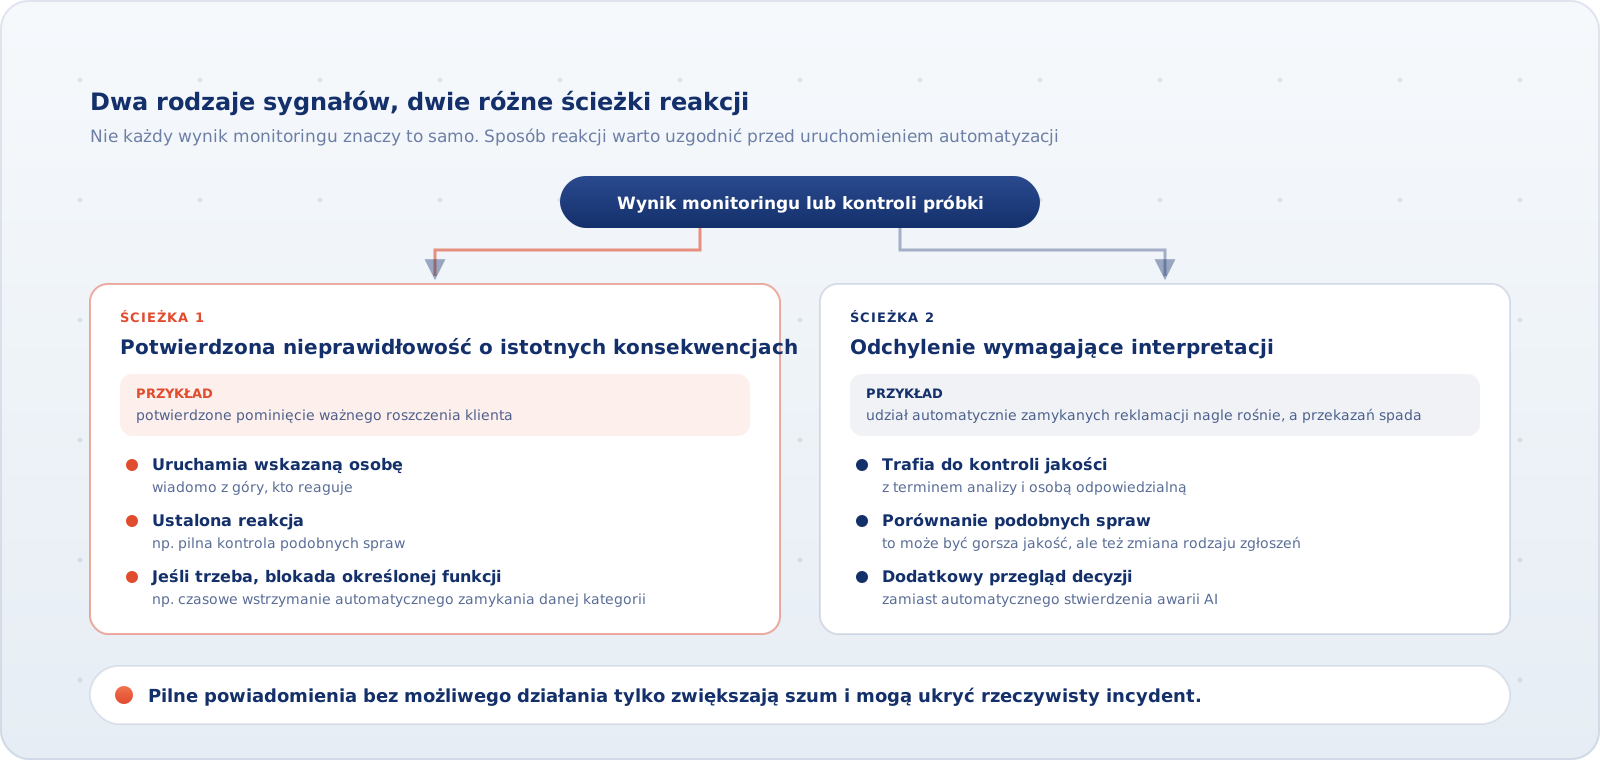
Nie wszystkie sygnały znaczą to samo. Jeżeli aplikacja wysłała klientowi bezwarunkowe potwierdzenie zwrotu, choć system płatniczy nie potwierdził jeszcze jego wykonania, mamy konkretny problem z komunikacją. Nie przesądza to, czy przelew ostatecznie nastąpił ani czy błąd popełnił model. Trzeba ustalić stan transakcji, skorygować informację i sprawdzić podobne przypadki.
Inaczej jest, gdy udział automatycznie zamykanych reklamacji nagle wzrasta, a liczba spraw przekazywanych pracownikom spada. To może być pogorszenie jakości, ale równie dobrze zmiana rodzaju zgłoszeń. Taki sygnał powinien uruchomić porównanie podobnych spraw i dodatkowy przegląd decyzji, nie automatyczne stwierdzenie awarii AI.
Dlatego przed uruchomieniem automatyzacji warto uzgodnić nie tylko sposób liczenia błędów, ale także co zespół zrobi z wynikami kontroli. Liczą się zarówno częstość i kierunek zmian, osobno dla istotnych rodzajów spraw, jak i konsekwencje pomyłek. Jeśli rośnie liczba drobnych błędów odpowiedzi, można zwiększyć zakres przeglądu i zbadać przyczynę. Pojedyncze potwierdzone pominięcie ważnego roszczenia może natomiast wymagać pilnej kontroli podobnych spraw i czasowego wstrzymania automatycznego zamykania danej kategorii. Jeden łączny procent błędów nie wystarczy do podjęcia obu decyzji.
Z tym wiąże się częstotliwość kontroli. Miesięczny przegląd może wystarczyć do obserwacji mniej istotnych odchyleń, ale nie może być jedynym zabezpieczeniem procesu, w którym błędna decyzja codziennie dotyka wielu klientów. Tam potrzebne są wcześniejsze sygnały, częstsza ocena lub automatyczne zatrzymanie jasno określonych działań.
Raportowanie warto więc połączyć z dwiema ścieżkami. Potwierdzona nieprawidłowość o istotnych konsekwencjach uruchamia wskazaną osobę i ustaloną reakcję, a jeśli trzeba, blokadę określonej funkcji. Odchylenie wymagające interpretacji trafia do kontroli jakości z terminem analizy i osobą odpowiedzialną. Pilne powiadomienia bez możliwego działania tylko zwiększają szum i mogą ukryć rzeczywisty incydent.
Co zrobić, kiedy AI zaczyna podejmować złe decyzje?
Załóżmy, że podczas przeglądu oryginalnych reklamacji wykryto kilka przypadków pominięcia drugiego żądania klienta. Osoba prowadząca kontrolę porównuje je z pozostałymi sprawami i zgłasza problem właścicielowi procesu. Ten ocenia jego konsekwencje i decyduje, czy ograniczyć automatyczne zamykanie zgłoszeń.
Nie trzeba od razu wyłączać całej aplikacji. Jeśli pozostałe funkcje działają prawidłowo, AI może nadal porządkować wiadomości, pobierać dane i przygotowywać propozycje odpowiedzi. Zakończenie danej klasy spraw zostaje natomiast przekazane pracownikom. Ktoś musi przejąć tę kolejkę, określić priorytety i zadbać, żeby klienci nie otrzymywali komunikatów o rozpatrzeniu reklamacji, które pozostają otwarte.
Równocześnie zespół techniczny sprawdza, czy problem wiąże się ze zmianą modelu, instrukcji, danych lub reguł procesu. Dobrze zaprojektowany zapis zdarzeń pozwala wybrać do ponownej oceny sprawy obsługiwane w określonym czasie, przy konkretnej konfiguracji i w odpowiedniej kategorii. Nie wystarczy jednak znaleźć daty ostatniej aktualizacji i założyć, że tylko te sprawy mogły ucierpieć. Zakres należy potwierdzić na rzeczywistych przypadkach.
Naprawienie przyczyny i naprawienie skutków to dwa osobne zadania. Po poprawce nowe zgłoszenia mogą być obsługiwane właściwie, ale wcześniej zamknięte reklamacje nadal wymagają ponownej oceny, a czasami kontaktu z klientem. Przywrócenie autonomii powinno nastąpić dopiero po weryfikacji poprawionego działania, ustaleniu sposobu rozliczenia dotkniętych spraw i decyzji osoby, która odpowiada za proces.
Kto odpowiada za to, że kontrola rzeczywiście działa?
W działającym procesie odpowiedzialność nie może kończyć się na stwierdzeniu, że „system monitoruje dostawca”. Trzeba osobno wskazać, kto ustala kryteria poprawności, kto wykonuje niezależny przegląd, kto reaguje na wyniki i kto może ograniczyć lub przywrócić automatyczne działanie.
Dla opisanego incydentu praktyczny podział jest następujący. Osoba odpowiedzialna za kontrolę jakości potwierdza pominięte żądania i wskazuje próbki. Właściciel procesu ocenia ryzyko, decyduje o czasowym ograniczeniu samodzielności systemu i zleca ponowne rozpatrzenie potencjalnie dotkniętych spraw. Pracownicy obsługi korygują skutki dla klientów. Zespół techniczny lub wykonawca ustala przyczynę i wdraża poprawkę. Dopiero po sprawdzeniu wyników właściciel procesu zatwierdza powrót do automatycznego zamykania zgłoszeń.
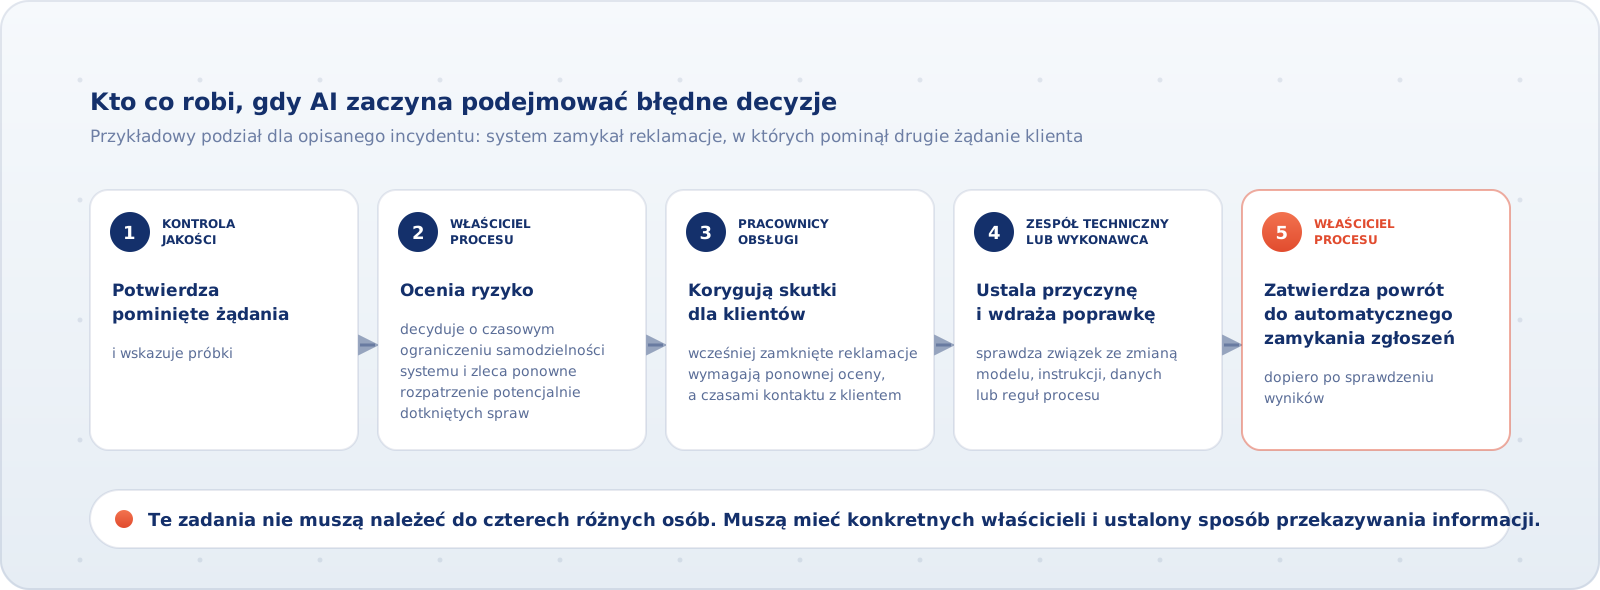
Te zadania nie muszą należeć do czterech różnych osób. Muszą jednak mieć konkretnych właścicieli i ustalony sposób przekazywania informacji. W umowie z dostawcą warto rozdzielić utrzymanie infrastruktury od obserwacji jakości decyzji AI, dostępu do niezbędnych danych, wsparcia przy incydencie i odpowiedzialności za uzgodnione poprawki. Sam fakt korzystania z zewnętrznego modelu nie przenosi automatycznie na jego dostawcę odpowiedzialności za rozpatrywanie reklamacji.
Najważniejszy sprawdzian jest praktyczny: czy po wykryciu błędnej decyzji potrafimy wskazać, jakie podobne sprawy mogły zostać obsłużone niewłaściwie, kto może zatrzymać dalsze automatyczne rozstrzygnięcia i na jakiej podstawie dopuści system do pracy ponownie?
AI nie wymaga ręcznego sprawdzania wszystkiego. Wymaga natomiast zaplanowanego sposobu obserwowania rzeczywistych decyzji, ich niezależnej oceny i korygowania działania wtedy, gdy jakość przestaje spełniać wymagania procesu. Działający system to nie tylko system dostępny technicznie, ale taki, którego wyniki firma potrafi regularnie weryfikować i za które bierze odpowiedzialność.