W raporcie z testów systemu AI widnieje 1000 prób i zero błędów. Zespół rekomenduje uruchomienie rozwiązania do obsługi klientów. Czy to wystarczy, żeby wyrazić zgodę?
Nie wiemy jeszcze nawet, czy wśród tych tysiąca prób znalazły się reklamacje, niejasne pytania i sytuacje wymagające przekazania sprawy konsultantowi. Być może wszystkie testy dotyczyły prostych, powtarzalnych pytań.
Przed wdrożeniem trzeba sprawdzić nie tylko wynik testów, lecz także to, czego rzeczywiście dowodzą.
Testowanie zaczyna się przed uruchomieniem AI
Dla systemu obsługi klientów naturalnym materiałem do testów są wcześniejsze rozmowy, wiadomości i zgłoszenia. Pokazują, o co klienci naprawdę pytają, jak formułują prośby i jakie sytuacje sprawiają zespołowi trudność.
Nie wystarczy jednak pobrać historii rozmów i sprawdzić, czy model odpowiada podobnie jak konsultant. Poprzednia odpowiedź pracownika również mogła być błędna, oparta na nieaktualnym cenniku albo niezgodna z dzisiejszą polityką firmy. W zbiorze mogą też być dziesiątki niemal identycznych pytań, które sztucznie poprawią wynik.
Dlatego przygotowanie materiału testowego wymaga dwóch rodzajów pracy. Osoby odpowiedzialne za proces ustalają, jaki rezultat jest właściwy: kiedy należy udzielić odpowiedzi, kiedy odmówić, a kiedy przekazać sprawę człowiekowi. Zespół techniczny przekłada te ustalenia na powtarzalne testy, uruchamia je i raportuje pomyłki. Sporne przypadki trzeba wcześniej rozstrzygnąć albo oznaczyć jako wymagające osobnej oceny.
Podobnie wygląda to przy AI rozpoznającej produkty ze zdjęć paragonów. Ktoś musi sprawdzić, jakie produkty faktycznie występują w materiale i co zrobić z pozycją nieczytelną. Bez wiarygodnej odpowiedzi wzorcowej możemy uznać błędny wynik AI za poprawny.
Przy korzystaniu z prawdziwych rozmów klientów trzeba też zadbać o podstawę ich wykorzystania, ograniczenie danych osobowych i odpowiednie zabezpieczenia. Samo usunięcie nazwiska nie zawsze wystarcza.
To nie jest praca administracyjna wokół testów. Od jej jakości zależy, czy test mierzy właściwą rzecz.
Typowe przypadki nie zastąpią tych najtrudniejszych
Zestaw testowy powinien odpowiedzieć na dwa różne pytania.
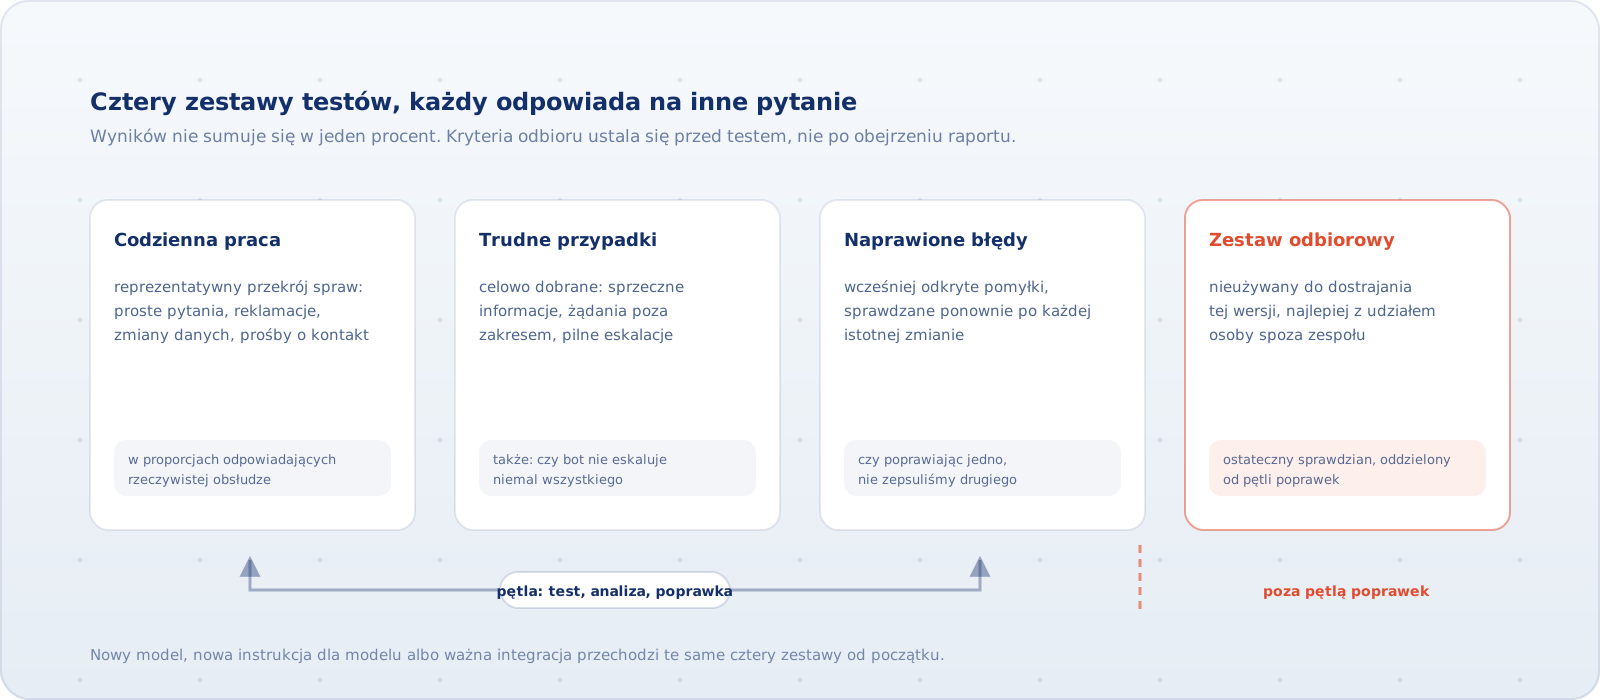
Jak system poradzi sobie w codziennej pracy? Do tego potrzebny jest możliwie reprezentatywny przekrój spraw: prostych pytań, reklamacji, próśb o zmianę danych czy kontakt z konsultantem, w proporcjach odpowiadających rzeczywistej obsłudze.
Czy system zawodzi tam, gdzie szczególnie nie powinien? To wymaga osobnego zestawu celowo trudnych przypadków. Na przykład klient podaje sprzeczne informacje, żąda działania, którego bot nie może wykonać, albo potrzebuje pilnego przekazania sprawy człowiekowi. Trzeba też sprawdzić, czy AI nie eskaluje bez potrzeby niemal wszystkich zgłoszeń.
Przy analizie umów zwykła próbka może prawie nie zawierać rzadkich, trudnych do wykrycia zobowiązań lub terminów. Dlatego należy przygotować dla nich oddzielne przypadki, zamiast liczyć na to, że pojawią się przypadkiem.
Wyników tych dwóch zestawów nie należy bezrefleksyjnie sumować w jeden procent. Pierwszy opisuje typową pracę. Drugi pozwala celowo szukać słabości. Potrzebujemy obu informacji.
Tysiąc udanych prób nie dowodzi 99,99% skuteczności
Istotne jest również, co znaczy „1000 testów”. Tysiąc powtórzeń tej samej rozmowy pozwala sprawdzić stabilność odpowiedzi na konkretny przypadek. Tysiąc różnych spraw daje szerszy obraz tego, z czym AI może się spotkać. Ale nawet tysiąc różnych spraw może być źle dobranych.
Nie ma uniwersalnej liczby testów, po której można uznać system za gotowy. Zakres sprawdzania zależy od tego, jakie zadania AI ma wykonywać, jak poważne mogą być błędy i jakie działania system będzie mógł podejmować samodzielnie.
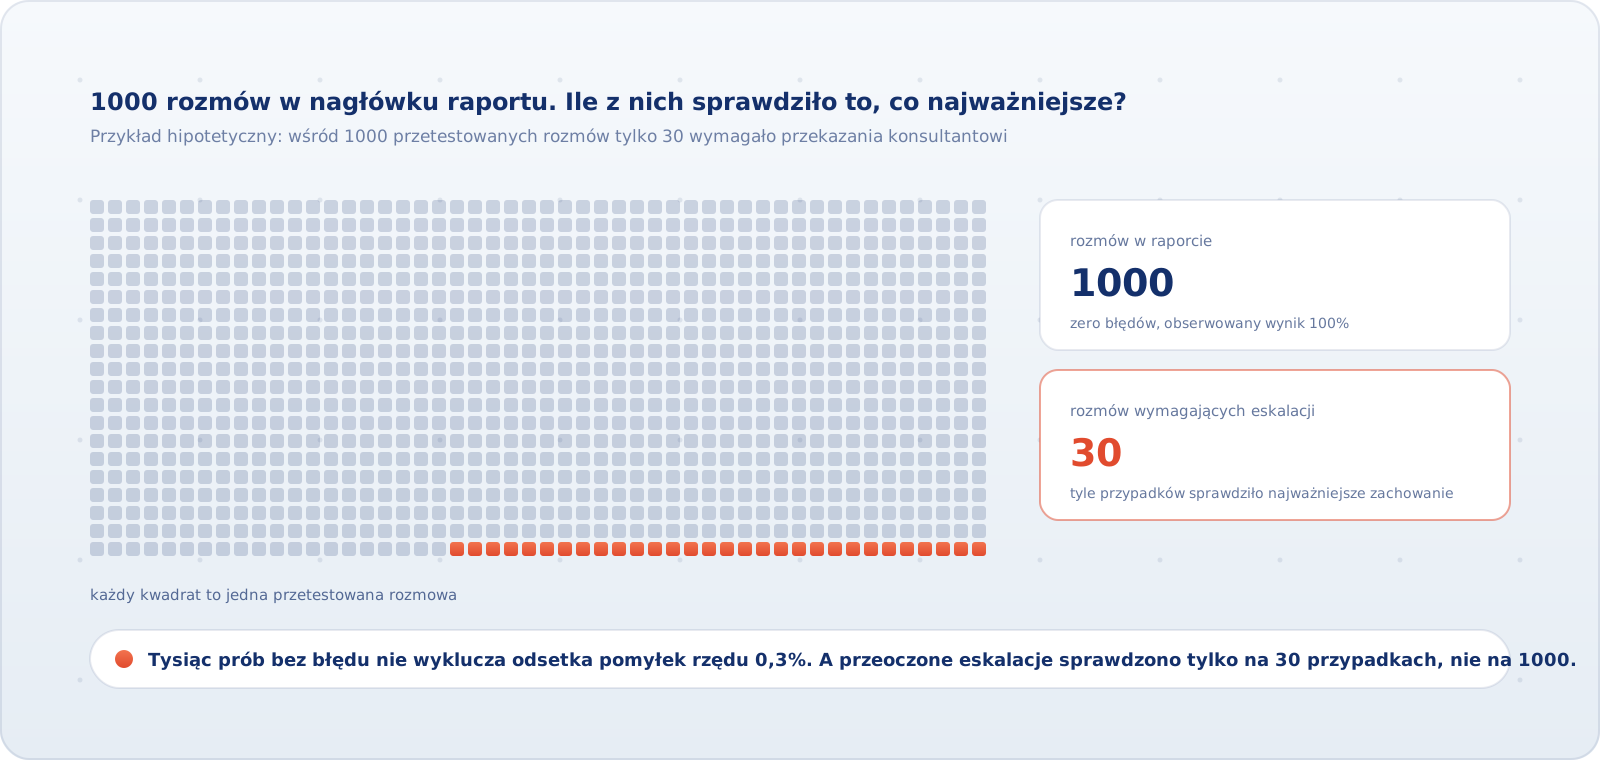
Załóżmy, że testowaliśmy 1000 niezależnych, reprezentatywnych przypadków, przy niezmienionej wersji systemu i wcześniej ustalonym kryterium błędu. Nie wykryliśmy ani jednej pomyłki. Obserwowany wynik wynosi 100%, lecz nie oznacza to, że system będzie bezbłędny w kolejnych sprawach. Pokazuje jedynie, jak duży odsetek błędów nadal jest zgodny z wynikiem testu przy przyjętych założeniach. Według prostej reguły statystycznej, przy tysiącu prób bez ani jednego błędu rzeczywisty odsetek pomyłek może wciąż sięgać około 0,3%. Z tysiąca udanych prób nie można więc wyprowadzić deklaracji 99,99% skuteczności. O tym, co kryje się za pojedynczym procentem, pisaliśmy w części o skuteczności AI.
A jeśli wśród 1000 rozmów tylko 30 wymagało przekazania konsultantowi? Do oceny przeoczonych eskalacji mamy zaledwie 30 właściwych przypadków, nie 1000. Duża liczba w nagłówku raportu może ukrywać bardzo mało testów najważniejszego zachowania.
Ostateczny sprawdzian musi być oddzielony od poprawek
Podczas tworzenia systemu zespół wielokrotnie uruchamia testy, analizuje błędy i zmienia instrukcje dla modelu, jego konfigurację lub integracje. To właściwy sposób pracy. Problem pojawia się wtedy, gdy po wielu poprawkach ogłasza sukces wyłącznie na tych samych, dobrze znanych przypadkach.
Potrzebny jest oddzielny zestaw odbiorowy, którego nie używano do dostrajania tej wersji rozwiązania. Wtedy możemy sprawdzić, czy poprawa dotyczy również spraw, pod które nie przygotowano systemu. Dodatkową wartość daje udział w odbiorze osoby spoza zespołu bezpośrednio tworzącego aplikację.
Osobno należy zachować wcześniej odkryte trudne przypadki. Po każdej istotnej zmianie sprawdzamy na nich, czy poprawiając jeden błąd, nie przywróciliśmy innego.
Równie ważne jest ustalenie przed testem, jaki wynik pozwala przejść dalej oraz które pomyłki blokują uruchomienie. Zmienianie tych zasad dopiero po obejrzeniu raportu odbiera testowi sens jako kryterium odbioru.
Sprawdź całą obsługę klienta, nie tylko odpowiedź modelu
Sam model może poprawnie uznać, że klient powinien porozmawiać z konsultantem. Ale jeśli aplikacja skieruje rozmowę do złego zespołu albo nie przekaże historii kontaktu, klient i tak nie zostanie właściwie obsłużony.
Podobnie odpowiedź może być poprawnie sformułowana, lecz oparta na nieaktualnym cenniku lub danych pobranych z niewłaściwego konta. Dlatego testy powinny obejmować również pobieranie informacji, wywoływanie narzędzi, wykonywane działania i przekazanie sprawy człowiekowi.
Trzeba również sprawdzić, co stanie się, gdy źródło danych będzie niedostępne albo zapis operacji się nie powiedzie. Czy system poinformuje o problemie i przekaże sprawę człowiekowi, czy spróbuje odpowiedzieć bez potrzebnych informacji? Czy ponowienie żądania nie spowoduje dwukrotnego wykonania tej samej czynności?
Poprawna eskalacja jest czasem prawidłowym wynikiem testu. Nie ma sensu karać systemu za to, że nie odpowiedział samodzielnie, jeśli właśnie tak powinien postąpić. Trzeba jednak równocześnie sprawdzać, czy nie przekazuje konsultantom spraw, które mógł bezpiecznie rozwiązać.
Próby obejmujące działania takie jak wysłanie wiadomości, zwrot pieniędzy czy zmiana danych klienta powinny najpierw przebiegać w kontrolowanym środowisku, bez wywoływania przypadkowych skutków w prawdziwych kontach.
Nowy model musi przejść ten sam egzamin
Po wdrożeniu może pojawić się tańszy lub szybszy model językowy. Sama zmiana modelu w aplikacji bywa niewielka, ale jego odpowiedzi, format danych czy sposób korzystania z narzędzi mogą być inne.
Dlatego nowy model powinien przejść te same porównywalne testy typowych spraw, trudnych przypadków i błędów, które wcześniej naprawiono. Następnie trzeba sprawdzić działanie całego procesu, w tym integracje i przekazywanie rozmów. Jeśli zmiana wprowadza nowe możliwości albo nowe ryzyka, zestaw testowy należy rozszerzyć.
Dotyczy to także zmian instrukcji dla modelu i ważnych integracji. Dopiero po potwierdzeniu jakości warto porównywać czas obsługi i rzeczywiste koszty działania nowego wariantu.
Pięć pytań przed zgodą na pilotaż
Raport z testów nie musi być rozbudowanym dokumentem technicznym. Powinien jednak pozwalać odpowiedzieć na pięć pytań:
- Skąd pochodzą przypadki testowe? Które odpowiadają codziennym sprawom, a które celowo sprawdzają sytuacje trudne i krytyczne?
- Kto zatwierdził poprawne rezultaty? Czy biznes uzgodnił zasady odpowiedzi, odmowy i eskalacji oraz rozstrzygnął przypadki niejednoznaczne?
- Jak mocne są wyniki? Ile było różnych przypadków, ile powtórzeń, ile testów dotyczyło najważniejszych błędów i czy przeprowadzono oddzielny test odbiorowy?
- Co nie zadziałało? Jakie błędy pozostały, czy sprawdzono integracje i czy system prawidłowo przekazuje sprawy do konsultantów?
- Czy spełniliśmy kryteria odbioru ustalone przed testami? Które warunki zostały spełnione, jakie błędy blokują uruchomienie i jaki zakres pilotażu możemy dopuścić? Jakie zabezpieczenia zastosujemy i co spowoduje zatrzymanie pilotażu?
Odpowiedzi powinny prowadzić do konkretnej decyzji: wracamy do poprawek i ponownie testujemy, uruchamiamy ograniczony pilot pod kontrolą albo wstrzymujemy start. Możemy na przykład dopuścić AI do podawania statusów zamówień, ale nie do samodzielnego wykonywania zwrotów, jeśli testy tej funkcji wykazały istotne błędy. Przekroczenie jednego procentowego progu nie oznacza automatycznej zgody na pełne wdrożenie. Dlaczego sam procent to za mało, pokazuje poprzednia część.
Tysiąc udanych prób może być dobrym wynikiem. Ważniejsze jest jednak to, jakie sytuacje te próby obejmowały, co zostało poza testami i na jakiej podstawie firma podejmuje decyzję o uruchomieniu. Dopiero taki raport pomaga zarządzać ryzykiem wdrożenia, zamiast zasłaniać je imponującą liczbą.