Jeśli program sumuje pozycje na fakturze, można łatwo sprawdzić konkretny przypadek: podać kwoty, uruchomić funkcję i porównać wynik z oczekiwaną sumą. Test zostaje zaliczony albo nie.
A co oznacza zaliczony test, gdy istotną część zadania wykonuje model językowy?
Załóżmy, że firma chce używać LLM do rozpoznawania pilnych zgłoszeń klientów. Model poprawnie zakwalifikował dziesięć różnych wiadomości. To dobry wynik tych dziesięciu prób, ale nie mówi jeszcze, jak poradzi sobie z kolejnymi, inaczej sformułowanymi sprawami. Nie odpowiada też na pytanie, czy identyczne zgłoszenie przy ponownym uruchomieniu zawsze trafi do tej samej kolejki.
Dziesięć poprawnych odpowiedzi potwierdza wynik dziesięciu prób. Nie mówi jeszcze, jak często system będzie się mylił ani jakie błędy może popełniać.
Dlaczego testowanie LLM wymaga innego podejścia?
Klasyczne testy nadal są potrzebne także w aplikacji wykorzystującej AI. Trzeba sprawdzać obliczenia, integracje, uprawnienia, zapis danych i skutki uboczne działania programu. Jednak gdy częścią aplikacji jest duży model językowy (LLM), dochodzi dodatkowa trudność. Ten sam tekst może zostać zinterpretowany lub opisany na różne sposoby. Niektóre różnice są nieistotne, inne mogą zmienić wynik całego procesu. Nawet przy tych samych danych wejściowych i instrukcjach nie zawsze można zakładać identyczną odpowiedź modelu.
Również oprogramowanie niezwiązane z AI może zachowywać się nieprzewidywalnie, na przykład przez błędy lub zależność od czasu. Nowym wyzwaniem jest ocena jakości komponentu, którego poprawny rezultat nie zawsze ma jedną identyczną postać.
I tu pojawia się pytanie: ile udanych uruchomień wystarczy? Jedno? Dziesięć? Sto?
Sama liczba prób niczego nie rozstrzyga. Dziesięć poprawnych odpowiedzi na niemal identyczne, łatwe zgłoszenia nie dowodzi, że system poradzi sobie z różnorodnymi przypadkami, które trafiają do firmy. Potrzebujemy ustalonego kryterium poprawności i wyników pomiaru odnoszących się do rzeczywistego zadania.
Najpierw ustal, co właściwie jest poprawnym wynikiem
W naszym przykładzie system ma oznaczać zgłoszenia jako pilne albo zwykłe. Zanim ocenimy jego odpowiedzi, firma musi ustalić, co sprawia, że zgłoszenie jest pilne.
Czy liczy się wyłącznie zatrzymanie pracy klienta? Czy także zagrożenie bezpieczeństwa, niemożność dotrzymania terminu albo zapis w umowie? Co z wiadomością, w której klient używa słowa „pilne”, choć pyta tylko o dokument? Bez takich ustaleń dwie osoby mogą inaczej ocenić ten sam przypadek. Nie będzie wtedy jasne, czy pomylił się model, czy nie uzgodniono zasad.
W tym zadaniu poprawnym rezultatem jest właściwa kwalifikacja zgłoszenia według przyjętych kryteriów. Model może napisać „wymaga natychmiastowej reakcji” albo „zgłoszenie pilne”. Jeśli oba sformułowania prowadzą do tej samej, właściwej decyzji, różnica w słowach nie jest błędem.
Inaczej wygląda sytuacja, gdy identyczne zgłoszenie raz zostaje skierowane do pilnej obsługi, a innym razem trafia do zwykłej kolejki. Tutaj zmienia się skutek biznesowy, nie styl wypowiedzi.
W systemach, które generują dłuższy tekst, dochodzi kolejne ryzyko: model może dopowiedzieć informację, której nie ma w dokumentach ani w danych. Na przykład obiecać klientowi konkretny termin naprawy, mimo że nikt go nie potwierdził. Taki przypadek należy odróżnić od zwykłego błędu klasyfikacji. Oba wymagają kontroli, ale nie są tym samym problemem.
Co może ukrywać 95% skuteczności?
Przyjmijmy prosty, hipotetyczny zestaw 1000 zgłoszeń klientów. Spośród nich 50 naprawdę wymaga pilnej reakcji, a 950 to zwykłe sprawy.
System oznacza wszystkie zgłoszenia jako zwykłe.
W 950 przypadkach jego odpowiedź jest prawidłowa. Otrzymujemy 95% ogólnej poprawności. Wygląda to przyzwoicie, dopóki nie zapytamy, po co system powstał.
Nie wykrył ani jednego z 50 pilnych zgłoszeń.
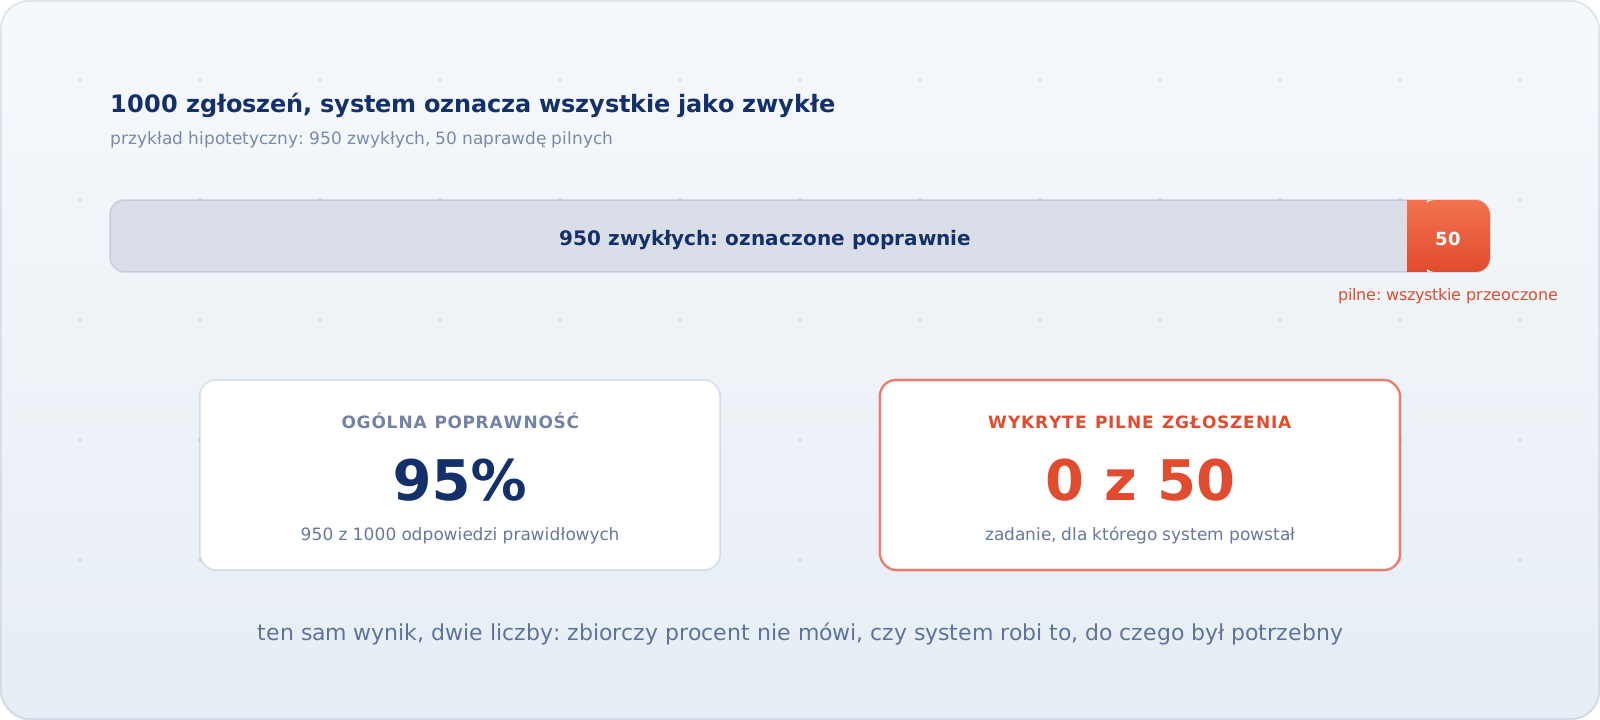
Nie jest to przykład rzeczywistego wyniku modelu, tylko rachunek pokazujący słabość jednej zbiorczej liczby. System może osiągać wysoki procent poprawnych klasyfikacji, ponieważ zdecydowana większość spraw należy do łatwiejszej, częstszej kategorii. Jednocześnie może całkowicie zawodzić przy zadaniu, dla którego firma najbardziej go potrzebuje.
Dlatego przy takiej klasyfikacji potrzebujemy co najmniej dwóch odpowiedzi.
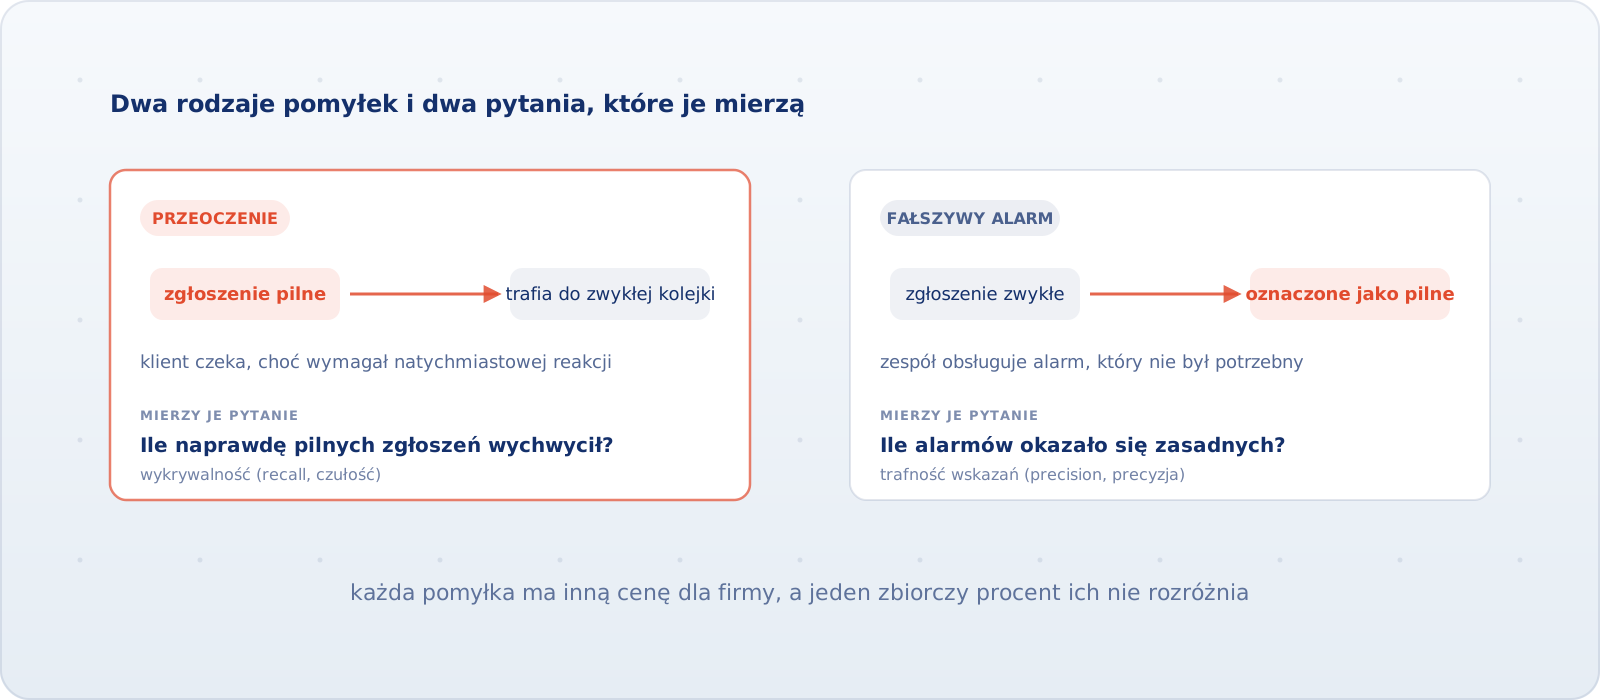
Ile naprawdę pilnych zgłoszeń system wychwycił? To miara wykrywalności, nazywana recall lub czułością. Jeżeli przeoczył wszystkie pilne sprawy, wynik dla tej kategorii wynosi zero.
Ile alarmów okazało się zasadnych? To trafność wskazań, nazywana precision lub precyzją. System może oznaczać zbyt wiele zwykłych spraw jako pilne, obciążając zespół fałszywymi alarmami. W naszym skrajnym przykładzie nie zgłosił żadnego alarmu, więc nie ma nawet podstaw do policzenia trafności jego alarmów.
Te dwie pomyłki są różne: przeoczenie sprawy, która wymagała reakcji, oraz fałszywy alarm, gdy zwykłą sprawę oznaczono jako pilną. Jeden procent ogólnej poprawności może ukrywać ich proporcje.
Co równie ważne, wynik na tysiącu różnych zgłoszeń nie mówi jeszcze, czy to samo zgłoszenie otrzymałoby identyczną kwalifikację przy ponownym uruchomieniu. To osobna cecha działania systemu.
Czy można wyeliminować halucynacje i zmienność odpowiedzi?
W systemie opartym na LLM można stosować ograniczenia formatów odpowiedzi, dodatkowe reguły, sprawdzanie informacji w źródłach, walidację wyników i przekazywanie niejasnych przypadków człowiekowi. Czasem prosta reguła po stronie aplikacji skuteczniej zapobiega konkretnemu błędowi niż kolejne instrukcje dla modelu.
Takie mechanizmy mają sens. Mogą znacząco ograniczyć określone rodzaje pomyłek. Nie należy jednak mylić zmniejszenia ryzyka z udowodnieniem, że żadna przyszła odpowiedź nie będzie błędna. Seria poprawnych wyników, nawet długa, nie stanowi takiej gwarancji.
Można również ograniczać rozbieżności między odpowiedziami przez odpowiednią konfigurację modelu i konstrukcję całego procesu. Nie powinniśmy jednak obiecywać pełnej powtarzalności tylko na podstawie ustawienia jednego parametru. W wielu zastosowaniach większe znaczenie ma zresztą stałość decyzji, a nie identyczność każdego wygenerowanego zdania.
Jeśli dostawca zapewnia, że rozwiązanie „nie halucynuje”, warto doprecyzować, co dokładnie ma na myśli. Czy wynik jest weryfikowany z ustalonym źródłem? Czy system może odmówić odpowiedzi? Jak zachowuje się, gdy nie ma wystarczających informacji? I jakie błędy nadal zaobserwowano w testach?
Nowszy model nie musi być lepszy dla Twojej firmy
Dobrze zdefiniowana poprawność pomaga także wtedy, gdy na rynku pojawia się nowy model językowy. Może być szybszy, tańszy w użyciu albo osiągać lepsze wyniki w popularnych rankingach. Nie wynika z tego automatycznie, że poprawniej zakwalifikuje zgłoszenia naszych klientów.
Sensowne porównanie dotyczy tych samych firmowych zadań i tych samych kryteriów jakości. Dopiero po takim sprawdzeniu można rozmawiać o przewagach modelu. Podmiana jego nazwy w konfiguracji bywa prosta, ale zmiana może również wymagać dostosowań integracji, instrukcji i ponownej oceny jakości. Sama cena wywołania nie wystarcza do wyboru.
O co warto zapytać przed akceptacją systemu?
Nie trzeba samodzielnie obliczać wszystkich metryk ani projektować testów. Warto natomiast oczekiwać od zespołu lub dostawcy pięciu konkretnych informacji:
- Jakie dokładnie zadanie wykonuje system? Jedna jasna czynność, np. oznaczenie zgłoszenia jako pilnego albo zwykłego
- Co oznacza poprawny wynik? Uzgodnione kryteria i przykłady odpowiedzi prawidłowych, błędnych oraz niejednoznacznych
- Jakie błędy rozróżniamy? Przeoczenia, fałszywe alarmy, pominięcia i informacje dopowiedziane bez podstaw, odpowiednio do zadania
- Na czym opiera się deklarowana skuteczność? Ile i jakich przypadków sprawdzono, ile było każdego rodzaju błędów oraz co konkretnie oznacza podany procent
- Czy sprawdzono stabilność istotnej decyzji? Czy ponowne wykonanie tego samego zadania może prowadzić do innego rozstrzygnięcia, nawet jeśli obie odpowiedzi wyglądają przekonująco
Bez tych informacji firma nie potrafi ocenić, co rzeczywiście potwierdzają wyniki testów. To za mało, by świadomie ocenić jakość rozwiązania.
Wynik testu nie jest jeszcze decyzją biznesową
W przypadku oprogramowania wykorzystującego LLM pytanie „czy działa?” jest zbyt ogólne. Znacznie więcej mówi nam wiedza, w jakich zadaniach system odpowiada poprawnie, jak często się myli i jakie pomyłki popełnia. Do tego potrzebne są ustalone kryteria i rzetelne wyniki sprawdzenia, a nie pojedynczy przykład z prezentacji.
Nawet informacja, że system wykonał poprawnie 99,8% sprawdzonych zadań, nie rozstrzyga wszystkiego. To opis wyniku w określonych warunkach, nie gwarancja na przyszłość. Pozostaje pytanie, co wydarzy się w tych przypadkach, w których system popełni błąd, i czy firma jest gotowa ponieść ich konsekwencje.