W jednym z systemów, które wdrażaliśmy w Codino, punkt wejścia wygląda banalnie. Dostajemy zdjęcie paragonu i chcemy odpowiedzieć na proste pytanie: co klient właściwie kupił?
Pierwszy odruch jest dziś dość oczywisty: wrzućmy zdjęcie do LLM i odbierzmy gotowe dane. Kiedy jednak zaczynamy przyglądać się całemu procesowi, szybko okazuje się, że „analiza paragonu” nie jest jednym problemem.
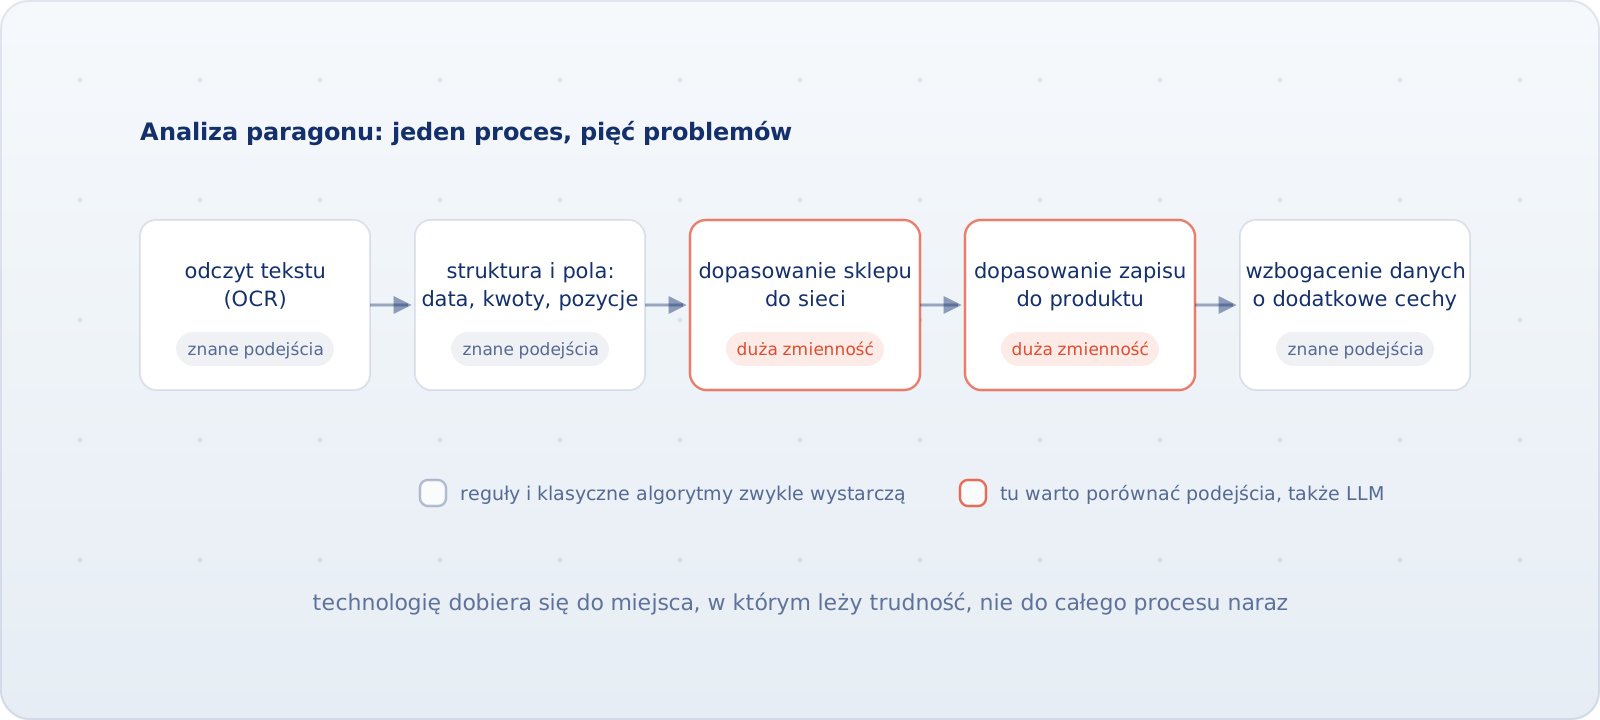
Trzeba odczytać tekst, zrozumieć strukturę dokumentu i wyciągnąć z niego datę, kwoty, sklep czy poszczególne pozycje. Później skróconą nazwę sklepu trzeba dopasować do konkretnej sieci, a zapis produktu z paragonu (często daleki od nazwy handlowej) do rzeczywistego produktu. Dalej dochodzi wzbogacanie tych danych o dodatkowe cechy i dopiero na tej podstawie można budować wiedzę o zachowaniach zakupowych klienta.
Z perspektywy biznesu to jeden proces. Od strony rozwiązania składa się jednak z kilku różnych problemów, które nie muszą mieć tej samej odpowiedzi technologicznej.
Dlatego zanim zapytam „którego LLM użyć?”, wolę zadać inne pytanie:
Co konkretnie daje nam LLM, czego nie daje prostsze podejście i z czym firma zostanie po wdrożeniu?
To rozróżnienie ma znaczenie także wtedy, gdy sam pomysł automatyzacji ma już dobry business case. Nawet opłacalny projekt można zepsuć, jeśli do prostego problemu dobierzemy rozwiązanie drogie w utrzymaniu albo niepotrzebnie trudne do zmiany.
Jeden proces może składać się z kilku zupełnie różnych problemów
Paragony mają pewne wspólne cechy, ale jednocześnie potrafią bardzo mocno różnić się między sklepami i przypadkami. Inaczej zapisane są nazwy produktów, rabaty, podatki czy dane sprzedawcy. Do tego dochodzi jakość zdjęcia, która też nie zawsze jest taka sama.
W tym projekcie porównywaliśmy kilka podejść. Jednym z nich był wariant możliwie end-to-end, w którym model dostaje obraz i próbuje od razu zwrócić potrzebne informacje. Innym jest użycie LLM tylko tam, gdzie zmienność i niejednoznaczność są największe. Sprawdzaliśmy też rozwiązania oparte na klasycznych algorytmach, heurystykach i regułach.
I właśnie tutaj pojawia się rzecz, która w praktyce jest ważniejsza niż wybór konkretnego modelu: nie ma jednego rozwiązania, które wygrywa zawsze.
Jeżeli obsługujemy dobrze znany zakres dokumentów, zależy nam na bardzo krótkim czasie odpowiedzi i niskim koszcie jednostkowym, sens może mieć podejście bardziej deterministyczne. Jeśli natomiast system ma szybko radzić sobie z nowymi formatami, niestandardowymi zapisami i dużą liczbą wariantów, większa elastyczność modelu może mieć dużo większą wartość.
Dochodzi jeszcze wymagany poziom jakości i rodzaj błędów, które jesteśmy gotowi zaakceptować. Pomyłka przy odczytaniu pola pomocniczego to przecież inny problem niż błędne rozpoznanie sklepu albo kwoty zakupów.
Dlatego rozkładam proces na części po to, żeby znaleźć miejsca, w których naprawdę występują trudności. Nie po to, żeby od razu przypisać każdej części osobną technologię.
Najprostszy element nie zawsze daje najprostszy system
Tu łatwo wpaść w drugą pułapkę.
Możemy dla każdego fragmentu znaleźć prosty mechanizm: parser, kilka reguł, osobny klasyfikator, dodatkową logikę do wyjątków i integracje pomiędzy nimi. Każdy element z osobna wygląda rozsądnie, ale po pewnym czasie może się okazać, że zmiana jednego wariantu dokumentu wymaga poprawek w kilku miejscach, a błąd pojawia się nie w pojedynczym algorytmie, tylko na styku dwóch poprawnie działających elementów.
W efekcie można podjąć kilka prostych decyzji technicznych i mimo to zbudować system, który będzie trudny do utrzymania.
Dlatego nie patrzę wyłącznie na to, czy pojedynczy element jest tani albo łatwy do zbudowania. Interesuje mnie również, ile własnej logiki trzeba będzie później utrzymywać, jak wiele zależności tworzymy, jak trudno będzie zmienić system za pół roku, czy da się łatwo odtworzyć przyczynę błędu i ile kosztuje codzienne działanie całości.
W praktyce sprowadza się to do prostego pytania:
Z czym firma zostanie po wdrożeniu?
Jeżeli „prosty” wariant oznacza dziesiątki reguł, wiele wyjątków i kilka miejsc, które trzeba zmieniać za każdym razem, gdy pojawia się nowy przypadek, jego prostota może być pozorna.
LLM może usunąć reguły. W zamian trzeba kontrolować model
To samo działa w drugą stronę.
LLM nie jest z definicji bardziej skomplikowanym rozwiązaniem. Jeżeli głównym problemem jest duża liczba wariantów języka, dokumentów albo sposobów opisu tej samej rzeczy, model może ograniczyć potrzebę ręcznego dopisywania kolejnych reguł i wyjątków.
W procesie analizy paragonów dobrze to widać. Odczyt konkretnej, jednoznacznej wartości może być prostym zadaniem. Próba dopasowania skróconej nazwy produktu do rzeczywistego produktu jest już zupełnie innym problemem, szczególnie gdy różne sklepy stosują własne skróty i konwencje.
Nie oznacza to automatycznie, że „tu musi być LLM”. Oznacza natomiast, że właśnie w takim miejscu warto porównać podejścia, bo koszt ręcznego opisywania kolejnych wariantów może z czasem okazać się większy niż koszt użycia modelu.
Tyle że ta praca nie znika. Po prostu przesuwa się w inne miejsce.
Zamiast utrzymywać rosnącą listę reguł, zaczynamy kontrolować jakość odpowiedzi modelu. Trzeba sprawdzać, jak zachowuje się na nowych danych, czy zmiana modelu albo instrukcji nie pogarsza wyników i co robić z przypadkami, w których odpowiedź jest niepewna.
Dlatego nie pytam, która technologia jest „prostsza z natury”. Bardziej interesuje mnie jaki rodzaj pracy i ryzyka zostawiamy sobie na później.
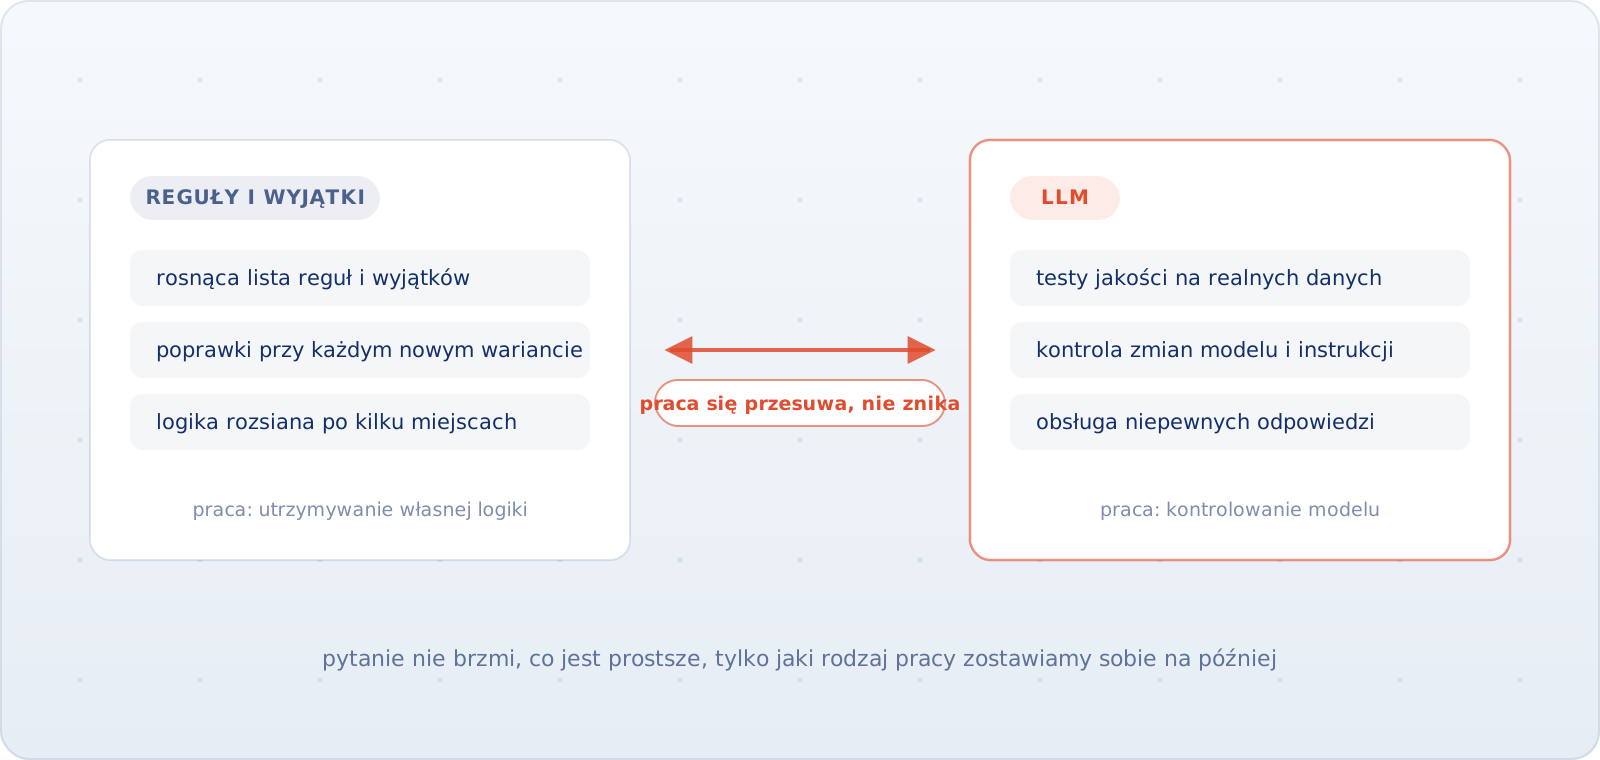
W jednym wariancie będzie to utrzymywanie reguł i wyjątków. W innym testowanie i kontrolowanie bardziej elastycznego modelu. W jeszcze innym najlepszy okaże się wariant mieszany, w którym LLM pracuje tylko tam, gdzie jego elastyczność rzeczywiście coś wnosi.
Właśnie dlatego w takich projektach nie zaczynamy od wyboru modelu. Najpierw sprawdzamy, gdzie leży trudność, a później porównujemy na realnych danych różne sposoby jej rozwiązania. Technologia jest konsekwencją wymagań procesu, a nie punktem startowym.
Trzy pytania, które zadałbym przed wyborem technologii
CEO nie musi wiedzieć, czy konkretny fragment lepiej rozwiąże parser, klasyczny model czy LLM. Powinien jednak oczekiwać od zespołu jasnego uzasadnienia, dlaczego proponowane rozwiązanie ma sens.
Pierwsze pytanie brzmi:
Gdzie w tym procesie naprawdę jest trudność?
Czy problem polega na wykonaniu znanej reguły, przeniesieniu danych między systemami, czy na interpretacji przypadków, których nie umiemy sensownie opisać z góry?
Drugie:
Co LLM daje nam ponad prostsze podejście albo co pozwala nam dzięki niemu usunąć?
Odpowiedzią nie musi być wyłącznie wyższa skuteczność. Wartością może być również mniej ręcznie utrzymywanych reguł, szybsze dodawanie nowych wariantów, mniejsza liczba osobnych modeli czy krótszy czas rozwoju systemu.
I trzecie:
Z czym firma zostanie po wdrożeniu: co trzeba będzie utrzymywać, zmieniać, kontrolować i za co regularnie płacić?
To ostatnie pytanie chroni przed obiema skrajnościami. Z jednej strony przed użyciem LLM tylko dlatego, że jest dostępny. Z drugiej przed budowaniem coraz większej liczby reguł i wyspecjalizowanych mechanizmów tylko dlatego, że każdy z osobna wydaje się prostszy.
W praktyce właśnie tak podchodzę do wyboru technologii w automatyzacji. Nie szukam najprostszej technologii. Szukam najprostszego rozwiązania jako całości, które spełni wymagania biznesowe.
Dobra decyzja nie polega więc na tym, żeby użyć jak najmniej AI albo jak najwięcej AI. Chodzi o rozwiązanie, które nie tylko zadziała na demo, ale będzie rozsądne do utrzymania, rozwijania i używania każdego dnia.
A kiedy wiemy już, jaki rodzaj rozwiązania ma sens, pojawia się następne pytanie: czy dane i systemy firmy są na tyle uporządkowane i dostępne, żeby rzeczywiście dało się je zbudować.