Ten sam bot, dwa światy
Wyobraź sobie bota do obsługi klienta z dokumentacją o długości 100 000 tokenów. Dwa zapytania, ten sam system prompt. Bez cache'u: koszt inputu to ~150 USD dziennie przy 500 requestach na Claude Sonnet 4.6, a pierwszy token pojawia się po 4–5 s. Z prompt cachingiem: ~15 USD dziennie i 1–2 s TTFT. Różnica to nie magia, tylko ponowne wykorzystanie wcześniej obliczonych stanów.
Anthropic oferuje to przez jawne oznaczanie bloków (cache_control), OpenAI robi to automatycznie. W obu przypadkach cache read kosztuje ~0,1× ceny standardowego inputu (90% oszczędności), a latencja przy długich promptach spada o 67–80%.
Skąd w ogóle ten koszt? Prefill i KV cache
Zanim model wyprodukuje pierwszy token odpowiedzi, musi najpierw "przeczytać" cały input. To tzw. faza prefill. Dla każdego tokena z 100 000-tokenowego promptu model oblicza reprezentacje wektorowe (tzw. stany key i value, czyli KV) i wykonuje self-attention: każdy token analizuje wszystkie poprzednie, żeby zrozumieć kontekst. Koszt tej operacji rośnie kwadratowo z długością promptu: dla 100K tokenów to setki miliardów mnożeń macierzowych. Dopiero po zakończeniu prefillu model zaczyna generować output. Stąd Time To First Token (TTFT) jest często znacznie dłuższy niż generacja kolejnych tokenów. Użytkownik czeka przede wszystkim nie na "dopisanie" odpowiedzi, ale na jej "przeczytanie".
W ramach jednego requestu model używa KV cache: po obliczeniu stanów key-value dla tokena nie liczy ich ponownie przy kolejnych krokach. Prompt caching rozszerza ten mechanizm poza granice pojedynczego requestu: jeśli kolejne zapytanie ma identyczny prefiks, stany KV są odczytywane z pamięci, nie liczone od zera. Badanie Prompt Cache (MLSys 2024) pokazuje redukcję TTFT od 1,5× do 10× na GPU i od 20× do 70× na CPU, bez zmiany parametrów modelu.
Mapa przestrzeni rozwiązań
Żeby nie zgubić się w terminologii, warto spojrzeć na dwie osie:
Oś poziomu:
- Intra-request: KV cache w ramach jednego zapytania (standard w vLLM, TGI).
- Inter-request: dzielenie obliczeń między zapytaniami w krótkim oknie (prompt caching API: Anthropic, OpenAI, Google Vertex AI).
- Inter-session: trwałe cache'owanie między sesjami użytkowników (np. Vertex AI explicit caching, vLLM APC on-premise).
Oś sterowania:
- Implicit: provider automatycznie wykrywa powtórzenia (OpenAI, Google Vertex AI domyślnie). Zero konfiguracji, brak kontroli.
- Explicit: deweloper oznacza fragmenty promptu jako cache'owane (Anthropic
cache_control). Pełna kontrola nad kosztami i deterministyczne zachowanie.
Google Vertex AI oferuje oba: implicit context caching (automatyczny, 90% zniżki na Gemini 2.5+) i explicit context caching (jawne tworzenie cache'ów z gwarancją zniżki).
Prompt caching w praktyce: układ promptu ma znaczenie
Największy błąd popełniany przy wdrażaniu cachingu dotyczy układu promptu. Prefix cache dopasowuje identyczny początek promptu od pierwszego tokenu. Jeśli na początku umieścisz cokolwiek, co się zmienia (timestamp, ID sesji, krótki wstęp per użytkownik), cały prefiks się zmienia i cache miss jest gwarantowany.
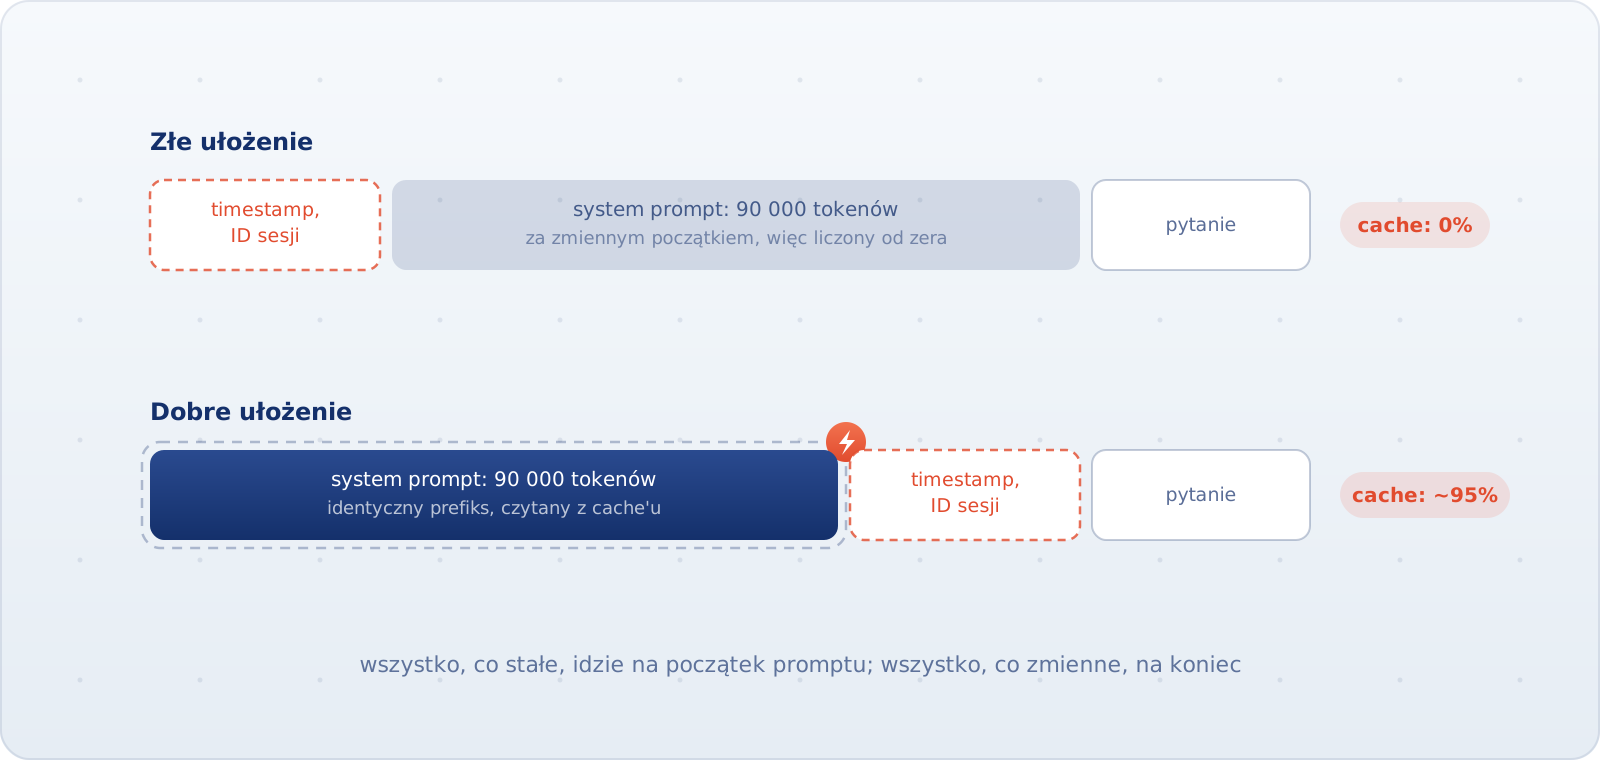
Zasada jest prosta: wszystko, co się nie zmienia (system prompt, dokumentacja, tool definitions), idzie na początek. Wszystko, co się zmienia (timestamp, ID sesji, retrieved documents, user query), idzie na koniec.
Eksperyment (sierpień 2025) pokazuje skalę problemu: stabilny prefiks dał medianę TTFT 953 ms, a zmienny 2727 ms. Różnica 65%. Najczęstszy błąd w produkcji to umieszczenie dynamicznych metadanych przed system promptem. Przeniesienie wszystkiego zmiennego na koniec sprawia, że 90 000 tokenów system promptu tworzy identyczny prefiks, a cache hit rate skacze z 0% do 80–95%.
Trzej gracze, trzy filozofie kosztów
| Provider | Sterowanie | Cache write / creation | Cache read | Min. tokenów | Storage cost | TTL |
|---|---|---|---|---|---|---|
| Anthropic | Explicit (cache_control) | 1,25× base (5 min) lub 2× (1 h) | 0,1× base | 512–4096 (zależnie od modelu) | Brak | 5 min lub 1 h |
| OpenAI | Implicit (automatycznie) | Brak dodatkowej opłaty | 0,1× base (GPT-5.x) do 0,5× (GPT-4o) | 1024 | Brak | 5–10 min (starsze), domyślnie 24h (GPT-5.5+) |
| Vertex AI (Gemini) | Implicit + Explicit | Standard input price (creation) | 0,1× base (Gemini 2.5+, 90%) lub 0,25× (Gemini 2.0, 75%) | 1024–4096 (zależnie od modelu) | Tak: per million tokens / hour (np. Gemini 3.1 Pro: $4.50/MTok/hr, Flash-Lite: $0.50/MTok/hr) | Implicit: do 24h. Explicit: konfigurowalny (domyślnie 1h) |
Kluczowa różnica Vertex AI względem konkurencji: płatny storage przy explicit caching. Anthropic i OpenAI nie pobierają opłat za przechowywanie cache'u, płacisz tylko za write i read. W Vertex AI tworząc explicit cache płacisz trzy razy: (1) standard input price za utworzenie, (2) storage za każdą godzinę trzymania cache'u, (3) zniżkony read przy użyciu. To zmienia ekonomię: przy dużych kontekstach i rzadkim ruchu koszt storage może zjeść oszczędności. Dla częstych zapytań w ramach jednej godziny wciąż się opłaca, ale wymaga dokładniejszego zarządzania TTL.
Semantic cache: osobna warstwa
Prefix caching optymalizuje obliczenia: nie licz tego samego dwa razy. Semantic cache optymalizuje trafność: nie pytaj modelu dwa razy o to samo. Badania wskazują, że 31% zapytań do LLM to semantyczne powtórki. Ale ponieważ użytkownicy rzadko powtarzają pytania dosłownie, proste porównanie token po tokenie praktycznie nigdy nie trafia.
Semantic cache rozwiązuje to inaczej: nowe zapytanie jest przekształcane na wektor (embedding) za pomocą modelu embeddingowego, a następnie wyszukiwane w vector DB pod kątem podobieństwa kosinusowego do wcześniejszych zapytań. Jeśli podobieństwo przekracza próg, system zwraca zapamiętaną odpowiedź bez wołania LLM.
Ale to wprowadza ryzyko: dwa różne pytania mogą być semantycznie bliskie, ale wymagać odmiennych odpowiedzi. Dobrze dostrojone systemy w benchmarkach osiągają 0,8% false positives, co wydaje się akceptowalne. Ale case study z banku pokazuje, że w realnym ruchu produkcyjnym ten sam system osiągał 3,8%, blisko 5× więcej. Laboratoryjne 0,8% to złudzenie bezpieczeństwa.
W praktyce oba mechanizmy współpracują. Prefix cache obniża koszt obliczeń na poziomie modelu, a semantic cache eliminuje zbędne wywołania LLM dla pytań, które już kiedyś padały. Nawet gdy semantic cache zawodzi, prompt może być tańszy dzięki prefix cachingowi, bo system prompt jest już obliczony.
Cztery pytania przed wdrożeniem
Zamiast wdrażać caching na ślepo, warto przejść przez cztery pytania decyzyjne.
Pytanie 1: Czy masz długi, stabilny prefiks?
Jeśli Twój system prompt + dokumentacja + tool definitions przekraczają 5 000–10 000 tokenów i zmieniają się rzadziej niż co godzinę, prompt caching przyniesie oszczędności. Jeśli prompt jest krótki (< 1 000 tokenów) lub dynamiczny, koszt cache write może przewyższyć oszczędności.
Pytanie 2: Jak wysoki jest Twój ruch i czy zapis do cache'u się zwróci?
Cache write kosztuje, ale nie u każdego providera. Przy explicit cachingu Anthropic płacisz 1,25× base input (5-min TTL) lub 2× base input (1-h TTL) za pierwsze przetworzenie bloku. Aby się zwróciło, potrzebujesz co najmniej jednego kolejnego cache hitu (przy 5-min) lub dwóch (przy 1-h). Przy implicit cachingu OpenAI nie ma dodatkowego kosztu cache write, ale retencja jest zależna od modelu: starsze modele (do GPT-5.4 włącznie) domyślnie trzymają cache 5–10 minut z opcją extended do 24h, a najnowsze modele (GPT-5.5 i nowsze) korzystają domyślnie z retencji 24h.
Jeśli rozważasz semantic cache, pamiętaj o koszcie vector search (~30 ms). Opłaca się dopiero przy hit rate ≥ 15–20% per kategoria. Wysokowolumenowe kategorie osiągają 40–60%, ale rzadkie zapytania specjalistyczne mają 5–15%, więc średni hit rate może być poniżej progu.
Pytanie 3: Czy zapytania są deterministyczne, czy kreatywne?
Prefix caching świetnie sprawdza się przy zadaniach deterministycznych: RAG, analiza dokumentów, generowanie kodu na podstawie specyfikacji, odpowiedzi na podstawie tool calls. Przy zadaniach kreatywnych (pisanie historii, brainstorming) użytkownicy rzadko powtarzają identyczne lub nawet podobne zapytania, więc cache hit rate będzie niski.
Pytanie 4: Jakie są konsekwencje błędnej odpowiedzi?
To pytanie kieruje nas ku semantic cache. Jeśli błędna odpowiedź oznacza utratę zaufania klienta, błąd medyczny lub stratę finansową, semantic cache musi być zabezpieczony dodatkową warstwą weryfikacji. W takich przypadkach może okazać się, że prompt caching (prefix) jest bezpieczniejszą i bardziej przewidywalną optymalizacją niż semantic cache.
Podsumowanie
Nie włączaj prompt cachingu, zanim nie odpowiesz na cztery pytania: czy masz stabilny prefiks, jaki jest Twój ruch, czy zapytania są deterministyczne i jakie są konsekwencje błędu.
Jeśli prefiks jest długi i stabilny, ruch wystarczający, a zapytania powtarzalne, masz przed sobą realną redukcję kosztów inputu o 90% i TTFT o 67–80%. Ale liczby te nie przyjdą same. Anthropic wymaga świadomego projektowania promptu i zapłaty za cache write. OpenAI działa automatycznie, ale nie daje kontroli nad tym, co trafia do cache'u. Vertex AI dodaje do rachunku koszt storage, co przy rzadkim ruchu może zjeść całe oszczędności.
Największy koszt leży w błędach: dynamiczna treść na początku promptu obniża hit rate z 95% do 0%, a laboratoryjne 0,8% false positive rate semantic cache w produkcji okazuje się bliżej 3,8%. Bez projektowania promptu, analizy ruchu i monitoringu per kategoria nie obniżysz kosztów.
Źródła
- Anthropic. Prompt Caching. https://platform.claude.com/docs/en/build-with-claude/prompt-caching
- OpenAI. Prompt Caching. https://developers.openai.com/api/docs/guides/prompt-caching
- vLLM. Automatic Prefix Caching. https://docs.vllm.ai/en/latest/design/prefix_caching/
- Gim et al. Prompt Cache. MLSys 2024. arXiv:2311.04934
- PwC / DeepResearchBench. arXiv:2601.06007
- Ankit Bko. Prompt Engineering for KV Cache Optimization. 2025. https://ankitbko.github.io/blog/2025/08/prompt-engineering-kv-cache/
- InfoQ. Reducing False Positives in RAG. https://www.infoq.com/articles/reducing-false-positives-retrieval-augmented-generation/
- arXiv:2510.26835. Category-Aware Semantic Caching for LLMs
- Introl. Prompt Caching Infrastructure Guide 2025. https://introl.com/blog/prompt-caching-infrastructure-llm-cost-latency-reduction-guide-2025
- Google Cloud. Vertex AI Context Caching. https://cloud.google.com/vertex-ai/generative-ai/docs/context-cache/context-cache-overview
- PremAI. Multi-Tier LLM Caching. https://blog.premai.io/